SCD-2: lưu lịch sử theo đoạn thời gian mà không phình bảng
Cách lưu lịch sử thay đổi của 100.000 khách hàng mà không phình bảng, vẫn trả lời được cả câu hỏi audit lẫn câu hỏi thống kê theo ngày. Bốn chỗ tôi làm khác sách vở, và lý do.
Bài toán
Hôm qua tôi đổi phần lưu lịch sử của một tool nội bộ sang SCD-2. Viết lại để khỏi quên, và vì tôi mất kha khá thời gian mới chọn được thiết kế cuối.
Để dễ hình dung, tôi kể bằng một ví dụ khác: hệ thống có 100.000 khách hàng, mỗi khách có vài thuộc tính đổi rất chậm, ví dụ gói cước đang dùng, tỉnh thành, kênh bán. Vài tháng mới đổi một lần, nhưng khi đổi thì phải giữ được cái cũ.
Có hai câu hỏi cần trả lời, và chúng rất khác nhau:
- Câu hỏi audit. “Khách này đổi từ gói Standard sang Premium lúc nào?” Cần biết chính xác đến giây.
- Câu hỏi thống kê. “Ngày 12/8 có bao nhiêu khách đang dùng gói Premium, tính riêng từng tỉnh?” Cần đếm được trạng thái của một ngày trong quá khứ, và lọc được theo tỉnh, theo kênh bán, theo bất cứ chiều nào.
Cách làm cũ của tôi là một bảng snapshot theo ngày, cộng một bảng log ghi lại từng lần đổi. Cả hai đều không ổn, mỗi cái sai một kiểu.
Vì sao snapshot theo ngày không ổn
Snapshot nghĩa là mỗi ngày chụp lại một ảnh toàn bộ dữ liệu rồi lưu thành các dòng mới.
Bảng phình rất nhanh. 100.000 khách × 365 ngày = 36,5 triệu dòng mỗi năm. Mà phần lớn các ngày chẳng có ai đổi gì. Tôi đang lưu 365 dòng cho một khách hàng không hề thay đổi.
Không lọc được chiều mới. Snapshot của tôi lưu số lượng khách theo gói, gộp theo tỉnh. Đến lúc cần tách theo kênh bán thì hết cách, vì dữ liệu đã bị gộp mất chi tiết ngay lúc ghi. Muốn thêm một chiều lọc thì phải có lại lịch sử chi tiết, mà lịch sử thì không tạo lại được.
Còn bảng log kiểu “trường X đổi từ A sang B” thì đọc audit rất tốt, nhưng không trả lời được câu hỏi thống kê. Muốn biết ngày 12/8 khách đó dùng gói gì, phải đọc toàn bộ log từ đầu đến ngày đó rồi tự dựng lại trạng thái. Không dùng cho thống kê được.
SCD-2 là gì
SCD-2 viết tắt của Slowly Changing Dimension type 2, tạm dịch: cách xử lý các thuộc tính thay đổi chậm, kiểu số 2. Đây là kỹ thuật quen thuộc trong data warehouse.
Ý tưởng gọn thôi: đừng ghi đè, hãy mở dòng mới.
Mỗi lần thuộc tính đổi, ta không update tại chỗ mà thêm một dòng mới. Mỗi dòng mang thêm hai cột thời gian cho biết dòng đó đúng trong khoảng nào:
valid_from— bắt đầu có hiệu lực từ ngày nàovalid_to— hết hiệu lực vào ngày nào
Dòng cũ không bị xoá, chỉ được đóng lại bằng cách điền valid_to.
Trong bài này tôi gọi mỗi dòng như vậy là một đoạn (tài liệu tiếng Anh gọi là segment): một khoảng thời gian mà khách hàng giữ nguyên một trạng thái.
Chuẩn SQL:2011 cũng có khái niệm này, gọi là temporal table (bảng có chiều thời gian). Phần cuối bài tôi nói vì sao vẫn tự làm tay thay vì dùng cái có sẵn.
Sơ đồ
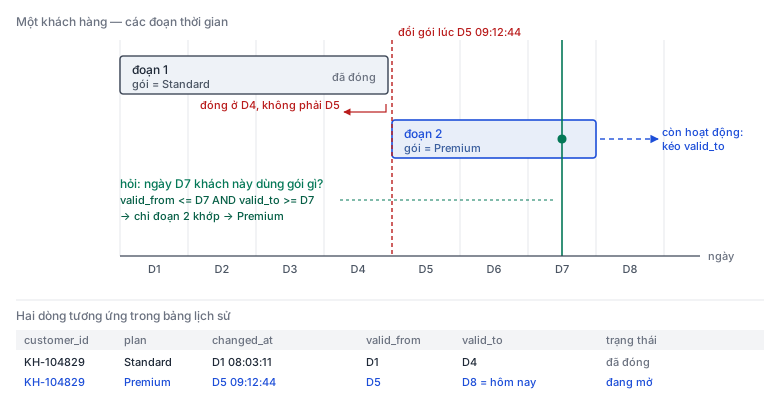
Đọc sơ đồ từ trên xuống:
- Khách đổi gói lúc
D5 09:12:44. - Đoạn cũ được đóng ở D4, không phải D5. Chỗ này quan trọng, tôi nói kỹ ở phần bẫy.
- Đoạn mới mở từ D5. Mỗi ngày khách còn hoạt động thì
valid_tođược đẩy lên hôm nay. - Hỏi “ngày D7 khách này dùng gói gì” chỉ là một điều kiện so sánh, và nó khớp đúng một đoạn.
Bốn chỗ tôi làm khác sách vở
Phần này là lý do tôi viết bài. Bốn quyết định dưới đây đều lệch khỏi cách làm chuẩn, và mỗi cái có lý do riêng.
1. Hai cột thời gian, không phải một
Bảng của tôi có ba cột thời gian, chia làm hai nhiệm vụ:
changed_at  DATETIME  NOT NULL,   -- mốc chính xác đến giây → dùng cho audit
valid_from  DATE      NOT NULL,   -- = ngày của changed_at   ┐ dùng cho
valid_to    DATE      NOT NULL    -- ngày cuối còn hiệu lực  ┘ thống kê
Nhìn qua thì valid_from là dư, vì nó chỉ là phần ngày của changed_at. Nhưng nó giải quyết đúng cái xung đột ở đầu bài.
Câu hỏi thống kê cần so sánh theo ngày. Nếu chỉ có changed_at kiểu DATETIME, mọi câu truy vấn thống kê phải viết WHERE DATE(changed_at) <= '2026-08-12'. Và đây là chỗ chết người: bọc một hàm quanh cột thì MySQL không dùng được index của cột đó nữa, nó phải tính DATE() cho từng dòng rồi mới so sánh. Bảng vài triệu dòng là hết cứu.
Ngược lại, nếu chỉ có valid_from kiểu DATE thì mất mốc chính xác. Audit chỉ trả lời được “ngày nào”, không trả lời được “lúc mấy giờ”.
Nên tôi để cả hai, mỗi cột một việc. Tốn thêm vài byte mỗi dòng, đổi lấy việc không phải chọn giữa hai thứ đều cần.
2. Không dùng cột is_current
Hầu hết tài liệu về SCD-2 đều khuyên thêm một cột is_current (hoặc is_active) đánh dấu dòng nào đang là dòng hiện hành. Tôi bỏ cột đó, và nhận biết đoạn đang mở bằng chính valid_to.
Lý do: is_current là thứ tính ra được từ dữ liệu đã có. Mà cái gì tính ra được rồi vẫn lưu thành cột riêng thì sớm muộn cũng có ngày hai chỗ nói khác nhau.
Cụ thể là thế này. Khi đổi gói, tôi phải làm hai việc: hạ cờ ở dòng cũ, bật cờ ở dòng mới. Nếu lỗi giữa hai việc đó, bảng sẽ có hai dòng cùng is_current = 1 cho một khách. Và MySQL không có ràng buộc nào chặn được chuyện đó cho bạn — nó không hiểu “mỗi khách chỉ được có một dòng hiện hành”.
Bỏ cột đi thì chỉ còn một nguồn sự thật duy nhất. Đổi lại, tìm đoạn đang mở phải dựa vào valid_to nên cần một index riêng cho việc đó. Tôi nói ở phần index.
3. valid_to cho biết khách còn hoạt động hay không
Đây là chỗ tôi lệch xa nhất so với sách vở, và cân nhắc lâu nhất.
Cách chuẩn để đánh dấu một đoạn còn đang mở là gán valid_to một giá trị rất xa trong tương lai: NULL, hoặc 9999-12-31. Ý nghĩa là “chưa biết bao giờ hết hiệu lực”. MariaDB làm đúng vậy: trong bảng temporal của nó, dòng hiện hành mang giá trị 2038-01-19 05:14:07.999999, tức mốc lớn nhất mà kiểu TIMESTAMP biểu diễn được.
Tôi làm khác: valid_to là ngày cuối cùng tôi còn thấy khách này hoạt động. Mỗi lần hệ thống đồng bộ, nếu trạng thái không đổi thì đẩy valid_to lên hôm nay. Kiểu như điểm danh mỗi ngày.
Được ba thứ:
- Biết được ai đã rời đi. Khách nào ngừng dùng dịch vụ sẽ để lại một đoạn có
valid_tođứng im ở ngày cuối họ còn hoạt động. Không cần thêm cộtlast_seen, không cần bảng riêng. Đọcvalid_tolà biết. - Câu truy vấn gọn hơn. Nếu dùng
NULLlàm “vô cực” thì mọi truy vấn phải viết(valid_to IS NULL OR valid_to >= '2026-08-12'), vì trong SQL,NULL >= ngàykhông trả về đúng mà trả vềNULL. Quên vếIS NULLmột lần là mất hết dòng hiện hành, và câu query vẫn chạy bình thường nên rất khó phát hiện. - Thống kê không bị đếm lố. Vì
valid_tokhông bao giờ vượt quá hôm nay, đếm số khách theo từng ngày sẽ không tính nhầm những người đã rời đi.
Đánh đổi, nói thẳng:
- Phải ghi mỗi ngày, không chỉ khi có thay đổi. 100.000 đoạn đang mở nghĩa là 100.000 lần update
valid_tomỗi ngày. Đây là cái giá thật, và tôi trả nó bằng quyết định thứ tư cộng phần “chỉ ghi cái đã đổi” bên dưới. - Không phân biệt được “đang hoạt động” với “vừa rời đi hôm nay”. Cả hai đều có
valid_tobằng hôm nay. Cần phân biệt thì phải có thêm một cờ ở bảng dữ liệu hiện hành.
4. Lưu thừa cột, có chủ ý
Bảng lịch sử của tôi giữ tất cả thuộc tính của khách hàng, không chỉ những cái tôi đang vẽ biểu đồ:
CREATE TABLE CustomerPlanHistory (
    id            BIGINT       NOT NULL AUTO_INCREMENT,
    customer_id   VARCHAR(64)  NOT NULL,   -- khoá nghiệp vụ

    -- Trạng thái: để rộng có chủ ý. Cần lọc thêm chiều nào thì thêm cột.
    plan          VARCHAR(32)  NULL,       -- Basic / Standard / Premium
    province      VARCHAR(64)  NULL,
    sales_channel VARCHAR(32)  NULL,       -- online / cửa hàng / đại lý
    contract_type VARCHAR(32)  NULL,
    detail_json   TEXT         NULL,       -- chi tiết đầy đủ, cho màn hình xem sâu

    -- Thời gian
    changed_at    DATETIME     NOT NULL,
    valid_from    DATE         NOT NULL,
    valid_to      DATE         NOT NULL,

    PRIMARY KEY (id),
    UNIQUE KEY uk_doan  (customer_id, changed_at),
    KEY idx_theo_ngay   (valid_from, valid_to),
    KEY idx_dang_mo     (customer_id, valid_to)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Đây chính là thứ chữa cái sai của bảng snapshot cũ. Snapshot gộp mất chi tiết ngay lúc ghi. SCD-2 giữ nguyên trạng thái của từng khách hàng, nên sáu tháng sau muốn lọc theo contract_type (chiều mà hôm nay tôi chưa dùng) thì dữ liệu vẫn còn nguyên đó.
Trong thiết kế database thường có nguyên tắc tránh lưu dữ liệu trùng lặp. Ở đây tôi cố tình phá nguyên tắc đó, vì bảng lịch sử là loại bảng chỉ thêm, không sửa, và mỗi đoạn phải là một ảnh chụp tự đủ của trạng thái lúc đó.
Ví dụ cho thấy vì sao: giả sử tôi không lưu province vào bảng lịch sử, mà mỗi lần cần thì join sang bảng khách hàng hiện tại để lấy. Khách chuyển từ Hà Nội sang Đà Nẵng. Ngay lúc đó, toàn bộ lịch sử ba năm trước của khách này cũng đổi thành Đà Nẵng, vì nó lấy từ bảng hiện tại. Báo cáo tháng trước bạn vừa gửi cho ai đó sẽ không còn khớp nữa, mà không có gì báo cho bạn biết.
Lịch sử phải bất biến. Nên nó tự giữ bản sao.
Truy vấn theo ngày, và chuyện index
Câu truy vấn cốt lõi ngắn đến mức đáng ngạc nhiên:
SELECT plan, COUNT(*)
FROM   CustomerPlanHistory
WHERE  valid_from <= '2026-08-12'
  AND  valid_to   >= '2026-08-12'
  AND  province = 'Hà Nội'
GROUP  BY plan;
Nhưng đây là chỗ tôi từng nghĩ sai. Index (valid_from, valid_to) không hiệu quả như trông có vẻ.
Index của MySQL là B-tree, và nó chỉ tận dụng được một cột ở dạng khoảng. Với valid_from <= '2026-08-12', index quét từ đầu bảng đến ngày đó. Đến cột valid_to thì nó không thu hẹp phạm vi quét được nữa, chỉ giúp loại bớt dòng mà không phải đọc dữ liệu thật. Với bảng chứa nhiều năm, valid_from <= D khớp gần hết bảng, nên phần việc thật gần như là quét toàn bộ.
Đây là hạn chế đã biết của B-tree khi có hai điều kiện khoảng. PostgreSQL có index GiST cho kiểu khoảng để giải chuyện này, MySQL thì không có tương đương.
Với 100.000 khách hàng, mỗi người đổi gói khoảng hai lần một năm, bảng sẽ tăng chừng 200.000 dòng mỗi năm, cộng 100.000 đoạn đang mở. Sau ba năm là ngót triệu dòng. Ở cỡ này thì không “để đó tính sau” được nữa. Hai cách:
- Chia bảng theo
valid_from(partition theo năm hoặc theo tháng). Truy vấn một ngày cụ thể chỉ cần đọc đúng phần chứa ngày đó, bỏ qua phần còn lại mà không cần nhìn tới index. Đây cũng là cách MariaDB tổ chức phần lịch sử của bảng temporal. - Đảo thứ tự index thành
(valid_to, valid_from)nếu bạn hay hỏi các ngày gần đây. Vìvalid_toluôn được đẩy lên hôm nay, các đoạn đang sống nằm dồn ở cuối index, nên hỏi ngày gần thì quét ít hơn nhiều.
Cách thứ hai gần như miễn phí, chỉ đổi một dòng DDL. Tôi làm cách đó trước, và để lại comment trong file migration về ngưỡng số dòng mà tôi sẽ bắt đầu chia bảng, để sáu tháng sau còn nhớ là đã nghĩ tới.
Index thứ hai, (customer_id, valid_to), phục vụ việc khác: tìm đoạn đang mở của một khách cụ thể. Đây là cái thay cho is_current. Nó bắt đầu bằng customer_id nên tra thẳng được, valid_to đứng sau để lấy đoạn mới nhất.
Ghi dữ liệu: chỉ ghi cái đã đổi
Quyết định số 3 sinh ra 100.000 lần update mỗi ngày. Đây là cách tôi trả cái giá đó.
Giữ đoạn đang mở trong bộ nhớ. Mỗi khách có đúng một đoạn đang mở, nằm trong một map trong RAM. Mỗi lần đồng bộ, so trạng thái mới với đoạn đang mở:
- Giống nhau → chỉ đẩy
valid_tolên hôm nay, và đánh dấu đoạn này “đã đổi kể từ lần ghi trước”. - Khác nhau → đóng đoạn cũ ở ngày hôm trước, xếp vào hàng chờ ghi; mở đoạn mới từ hôm nay.
Ghi xuống DB theo chu kỳ, và chỉ ghi những đoạn đã được đánh dấu. Đây là chi tiết quan trọng nhất về hiệu năng. Nếu mỗi chu kỳ ghi lại cả 100.000 đoạn đang mở thì tải ghi rất nặng, mà 99% là ghi lại y nguyên giá trị cũ. Giữ một danh sách “đoạn đã đổi” thì mỗi lần chỉ ghi đúng những cái thật sự cần.
Ghi lỗi thì xếp lại vào hàng chờ, không bỏ. Nếu ghi DB thất bại, cả lô được đẩy lại vào hàng đợi để chu kỳ sau thử tiếp. Không mất bản ghi nào.
Cách này gọi là write-behind: gom thay đổi trong RAM rồi ghi xuống DB sau, thay vì ghi ngay mỗi lần có thay đổi.
Đánh đổi có chủ ý: nếu process chết giữa hai chu kỳ ghi, các thay đổi kể từ lần ghi trước sẽ mất, khởi động lại sẽ nạp lại từ DB. Muốn an toàn hơn thì rút ngắn chu kỳ. Không có cách nào vừa ghi ít vừa không mất gì, chỉ có việc chọn điểm nào giữa hai đầu.
Nhưng có một thứ không được đánh đổi: đóng đoạn cũ và mở đoạn mới phải nằm trong cùng một transaction. Nếu chỉ một nửa được commit thì hoặc có ngày trống không đoạn nào, hoặc có hai đoạn cùng chứa một ngày. Cả hai đều làm thống kê sai mà không báo lỗi gì.
Năm cái bẫy
Lệch một ngày khi đóng đoạn. Đóng ở ngày hôm trước ngày đổi, không phải ngày đổi. Nếu đóng ở đúng ngày đổi thì cả hai đoạn đều chứa ngày đó, và truy vấn ngày đó trả về hai dòng cho một khách. Thống kê đếm gấp đôi. Đây là lỗi dễ mắc nhất và khó thấy nhất, vì nó chỉ sai ở đúng những ngày có thay đổi, còn lại đều đúng. Viết test riêng cho ca này.
Đổi nhiều lần trong cùng một ngày. Nếu khoá duy nhất là (customer_id, valid_from) thì lần đổi thứ hai trong ngày sẽ đụng khoá và ghi lỗi. Đưa changed_at vào khoá thay cho valid_from là xong, vì changed_at chính xác đến giây nên vẫn phân biệt được. Nhưng nhớ hệ quả: trong một ngày sẽ có nhiều đoạn cùng valid_from, và truy vấn ngày đó trả nhiều dòng. Thống kê của bạn phải biết chọn đoạn cuối trong ngày.
Múi giờ. Việc lấy phần ngày từ changed_at phụ thuộc múi giờ của kết nối. Hai server đặt múi giờ khác nhau sẽ sinh ra valid_from lệch nhau một ngày cho cùng một sự kiện. Chốt múi giờ ở tầng kết nối, đừng để mặc định.
Dữ liệu về muộn. Nếu một thay đổi tới sau khi bạn đã mở đoạn mới hơn, chèn nó vào giữa đòi hỏi phải cắt đoạn hiện có ra làm hai. Tôi chưa xử lý ca này, vì nguồn dữ liệu của tôi là đồng bộ định kỳ nên luôn đi về phía trước. Nếu nguồn của bạn có thể về muộn thì phải thiết kế từ đầu, vá sau rất đau.
Join sang bảng hiện tại. Đã nói ở quyết định 4, nhắc lại vì nó phá lịch sử theo cách rất khó phát hiện. Mọi thứ hiển thị trong ngữ cảnh lịch sử phải lấy từ chính đoạn đó.
Vì sao không dùng temporal table có sẵn
Câu hỏi hợp lý, vì chuẩn SQL:2011 đã có sẵn tính năng này và MariaDB hỗ trợ từ bản 10.3. Cú pháp cũng gọn hơn tay tôi viết nhiều, chỉ cần AS OF '2026-08-12' là xong.
Hai lý do:
MySQL không có. Tính năng này có ở MariaDB, không có ở MySQL. Đây là lý do thực dụng và nó quyết định luôn.
Nhưng kể cả có, nó giải bài toán khác. Bảng temporal của DB theo dõi vòng đời của dòng dữ liệu: mọi lần UPDATE đều sinh một bản ghi lịch sử, kể cả những lần đổi các cột tôi hoàn toàn không quan tâm. Còn tôi cần theo dõi vòng đời của trạng thái nghiệp vụ: chỉ mở đoạn mới khi những thuộc tính tôi chọn thay đổi. Cột last_seen_at nhảy mỗi phút thì không được sinh ra đoạn nào cả.
Nói theo ngôn ngữ của chuẩn: cái có sẵn cho tôi system time (thời gian của hệ thống), còn tôi cần application time (thời gian của nghiệp vụ). Phần thứ hai của chuẩn thì các DB hỗ trợ thưa thớt hơn nhiều.
Điều đáng học từ MariaDB thì tôi vẫn lấy: cách nó chia phần lịch sử theo thời gian để truy vấn dữ liệu hiện hành không phải chạm vào lịch sử. Đó là hướng đi của tôi khi bảng lớn lên.
Quy chuẩn
- Đóng đoạn cũ và mở đoạn mới trong một transaction. Làm nửa vời là sai dữ liệu âm thầm.
- Không dùng cột
is_current. Đoạn đang mở nhận biết quavalid_to. - Đóng ở ngày hôm trước ngày đổi. Viết test cho đúng ca này.
- Khoá duy nhất dùng
changed_at, không dùngvalid_from. - Bảng lịch sử chỉ thêm, không sửa. Ngoại lệ duy nhất là cập nhật
valid_to. - Mỗi đoạn phải tự đủ. Không join sang bảng hiện tại để hiển thị lịch sử.
- Chốt múi giờ ở tầng kết nối.
- Chỉ ghi những đoạn đã đổi, đừng ghi lại toàn bộ mỗi chu kỳ.
- Ghi lỗi thì xếp lại hàng chờ, đừng bỏ lô.
- Ghi lại trong file migration cái ngưỡng số dòng mà bạn sẽ bắt đầu chia bảng.
Bài này là phần tiếp của thiết kế batch insert dữ liệu lớn. Ở bài đó tôi thêm một bảng history vào luồng đổi bảng A/B. SCD-2 là cách tổng quát hoá đúng đắn của ý tưởng ấy: thay vì một bảng history rời rạc, chính bảng lịch sử trở thành nguồn dữ liệu cho cả audit lẫn thống kê.